「ChatGPT に自社の文体を覚えさせたい」「RAG だけでは足りない気がする」── そんな課題で ファインチューニング に辿り着いた方へ。
結論から言うと、ファインチューニングは 既存の LLM に追加データで再学習をかけて、特定タスクや文体に特化させる仕組み です。「モデルの体質改善」と捉えると分かりやすいです。
この記事では、ファインチューニングの定義 → 仕組み → RAG・プロンプトエンジニアリングとの違い → 向き不向き → コスト感、を整理します。
結論:3行まとめ
- ファインチューニング = 既存 LLM に追加学習をかけて、特定用途に特化させる手法
- プロンプト・RAG では難しい「文体の固定」「形式の遵守」「専門用語の正確さ」が得意
- ただし データ準備とコストが地味に重い。まず RAG / プロンプトで試すのが現実解
ファインチューニングとは ― 言葉の意味と全体像
ファインチューニング(fine-tuning) は英語で「微調整」を意味します。AI 分野では、事前学習済みのモデルに、追加の学習データを与えてさらに学習させる手法 を指します。
事前学習との関係
LLM が出来上がるまでには 2 段階あります。
| 段階 | やること | コスト |
|---|---|---|
| 事前学習(pre-training) | ゼロから巨大データで作る | 超高コスト(数億〜数十億円規模) |
| ファインチューニング | できあがったモデルを微調整 | 相対的に低コスト(数万〜数十万円のレンジ) |
私たちが手を入れられるのは主に ファインチューニング側 です。
「モデルの体質改善」の比喩
完成しているスポーツ選手に、特定の競技スタイル を覚え込ませるトレーニングをイメージすると分かりやすいです。基礎体力(事前学習)はそのまま、用途に応じた動きを身につけさせる、というイメージです。
なぜファインチューニングが必要なのか
プロンプトや RAG で足りる場面も多いですが、以下のようなケースでは限界が出てきます。
プロンプトだけでは限界がある場面
- 毎回同じ前提を入れる手間:プロンプトが長くなり、運用コストが増える
- 文体・トーンの揺れ:プロンプトで指示しても出力に微妙な揺らぎが残る
- 専門用語の正確さ:業界特有の用語をプロンプトで都度指定するのは現実的でない
プロンプトエンジニアリング で工夫できる範囲には限界がある、ということです。
RAG だけでも足りない場面
RAG は 外部知識を都度渡す 仕組みなので、知識の問題は解決します。しかし以下は RAG では対応しにくいです。
- 言い回し・文体の固定:参考資料を渡しても、AI の語り口は変わりにくい
- 出力フォーマットの厳密な遵守:JSON 形式・固定テンプレートなど
- 専門領域に最適化された推論:判断ロジック自体を学ばせたい場合
業務での具体的なニーズ
- 「○○社らしい文体で社内マニュアルを書き続けてほしい」
- 「決まった JSON 形式で安定して出力してほしい」
- 「医療・法律など専門領域の用語を間違えずに使ってほしい」
こうした要件に応えるのがファインチューニングです。
ファインチューニングの仕組み ― 3 ステップ
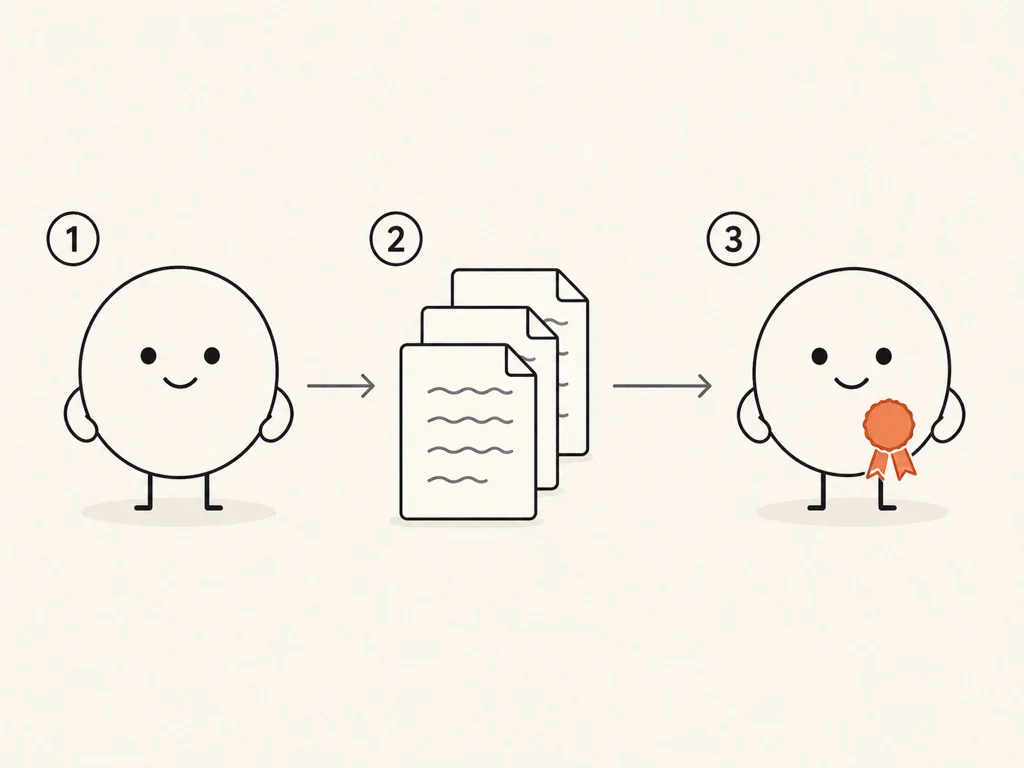
技術的な詳細は省きますが、概念的にはシンプルな 3 ステップです。
Step 1:学習データを用意する
「入力 → 期待される出力」のペアを 数百〜数千件以上 用意します。
例:カスタマーサポート向けにファインチューニングするなら:
入力:「返金できますか?」
出力:「ご購入から30日以内であれば、以下の手順で返金可能です…」

入力:「配送が遅れています」
出力:「ご迷惑をおかけしております。追跡番号をお教えいただけますか…」
このようなペアを大量に集めるのが 最大のボトルネック です。
Step 2:追加学習を実行する
既存モデル(GPT / Claude / Gemini / オープンソースモデル)のパラメータに対し、追加のデータで再学習 をかけます。実行は提供元の API か、自前環境で行います。
学習時間は数十分〜数時間、データ量・モデルサイズによって変動します。
Step 3:完成したモデルを呼び出す
ファインチューニング完了後、専用のモデル ID が発行されます。普段の API 呼び出しと同じ要領で、その ID を指定して使うだけです。
ファインチューニングと他のアプローチの違い
業務 AI 活用では 3 アプローチが選択肢 になります。
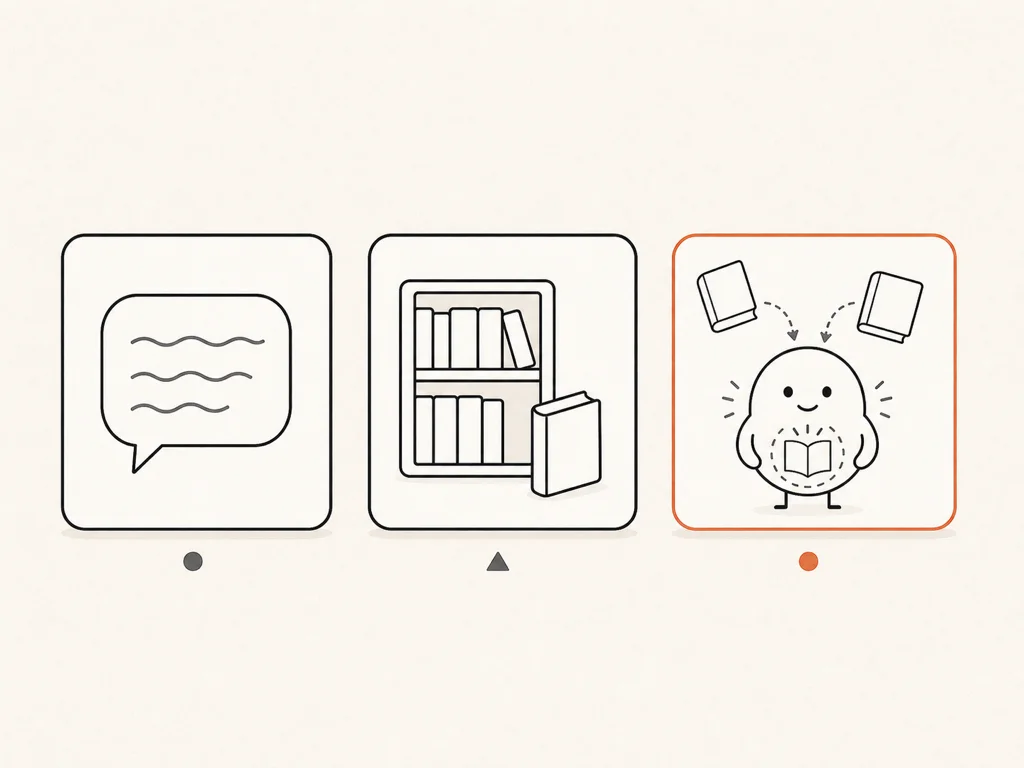
| 観点 | プロンプトエンジニアリング | RAG | ファインチューニング |
|---|---|---|---|
| やること | 都度の指示で誘導 | 外部知識を都度渡す | モデルを再学習 |
| コスト | 低 | 中 | 高 |
| 即時性 | 即実行可能 | 数日で構築可能 | 数日〜数週間 |
| 文体・形式の固定 | 弱い(揺れる) | 弱い | 強い |
| 情報更新の容易さ | 高(プロンプト書き換え) | 高(ドキュメント差し替え) | 低(再学習必要) |
| 専門知識の要件 | 軽い | 中 | 重い |
判断軸(私のおすすめ順序)
- まずプロンプトエンジニアリングで試す
- 足りなければ RAG を追加
- それでも文体・形式が揺れるならファインチューニング
「ファインチューニングは最後の手段」と捉えると、過剰投資を避けられます。
ファインチューニングが向くケース/向かないケース
| 向くケース | 向かないケース |
|---|---|
| 一定の文体・トーンを保ちたい | 情報が頻繁に更新される |
| 出力形式を厳密に守らせたい | 学習データを用意する余裕がない |
| 専門用語を正確に扱いたい | 試行段階・PoC レベル |
| 毎回長いプロンプトを書く手間を減らしたい | 数件のサンプルしか集められない |
「向かないケース」に当てはまるなら、まず RAG / プロンプトで試す のが王道です。
コスト・難易度の整理
2026 年 5 月時点の概況です。
データ準備の労力
- 数百〜数千ペアを作るのは 地味に大変
- 既存ログ(社内 Q&A・サポート履歴・過去文書)から抽出する設計が現実的
- データの 質 が結果を左右する(ゴミ in ゴミ out)
学習実行のコスト
- 提供元の料金体系で 数万円〜数十万円のレンジ が個人〜中小規模の目安
- データ量・モデルサイズで変動
- 詳細は各社の公式ページで最新確認を
専門知識の要件
- データ整形・学習パラメータ調整・評価方法の理解が必要
- 業務側だけでは難しく、エンジニアとの協業 が前提になることが多い
主要なファインチューニング提供サービス
- OpenAI:GPT 系列のファインチューニング API(成熟)
- Anthropic:Claude のカスタム学習(提供形態は変動)
- Google:Gemini のファインチューニング機能
- オープンソース:Llama / Mistral / Qwen などを自前ファインチューニング
仕様・料金は変動するため、公式ページで最新確認 をお願いします。
注意点・限界
便利な手法ですが、いくつか押さえておくべき点があります。
ベースモデルの基本性能は超えない
ファインチューニングは「特化」させる手法であり、ベースモデルの上限を超える性能 は出ません。GPT-3.5 をファインチューニングしても GPT-4 にはなりません。
学習データの質次第で性能が落ちる場合もある
ノイズの多いデータでファインチューニングすると、かえって性能が下がる ことがあります。「データ量さえあれば良い」は誤解です。
一般タスクの性能が下がる(catastrophic forgetting)
特定タスクに特化させすぎると、他のタスクで以前より下手になる 現象が起こります。「専門化と汎用性のトレードオフ」が常に付きまといます。
ハルシネーションは消えない
ファインチューニングは LLM の特性そのもの を変えません。事実誤認(ハルシネーション)は引き続き起こります。詳細は ハルシネーションとは? を参照してください。
モデルの著作権・データ取扱い
- 学習に使ったデータの著作権
- ファインチューニング済みモデルの所有権
- 機密データを学習に使うことの社内ポリシー
業務利用前に 法務 / セキュリティ部門との確認 が欠かせません。
まとめ ― ファインチューニングは「モデルの体質改善」
最後に要点を整理します。
- ファインチューニング = 既存 LLM に追加学習をかけて、特定用途に特化させる手法
- プロンプト・RAG では難しい 文体固定・形式遵守・専門用語 に強い
- データ準備・コスト・専門知識が地味に重い
- 「まず プロンプト → RAG → それでも足りなければファインチューニング」が現実解
- ハルシネーションなどの LLM の限界は依然として残る
業務 AI を本気で運用フェーズに乗せたいタイミングで、選択肢として持っておくと役立ちます。
次に読む
- RAGとは?仕組みと使いどころを初心者向けに解説 ― ファインチューニングと並ぶ業務 AI の主要アプローチ
- プロンプトエンジニアリング基本の型 5 選 ― ファインチューニング前にまず試したい
- ハルシネーションとは? ― ファインチューニング後も残る課題
- LLMとは? ― 基礎の振り返り